MiniMax M3.1 Flash: precio de liquidación y la aritmética del 70%
Cortita: MiniMax lanzó M3.1 Flash y lo vendió con una frase jugosa: 70% menos costo por tarea agéntica que su versión anterior. Los precios públicos bajan fuerte —entrada a la mitad, caché a un cuarto—, pero la cuenta real depende de cuántos tokens tire el modelo. Hay una sospecha incómoda: que las tablas del anuncio están maquilladas.
Qué anunció MiniMax (y qué no)
El modelo se llama M3.1 Flash, es de pesos abiertos —aunque los pesos todavía no están publicados— y llega con tres números grandes: 428.000 millones de parámetros totales, 23.000 millones activos, y una inferencia hasta tres veces más rápida que el M3 original. En la tabla de precios, la entrada queda en 0,15 dólares por millón de tokens, la salida en 0,60 y la lectura de caché en 0,015.
Comparado con el M3 de antes (0,30 / 1,20 / 0,06), es la mitad en entrada y salida, y un cuarto en caché. De ahí sale el titular del 70%: para tareas agénticas, dicen, el costo de uso baja siete décimos. Lo que no dicen es con qué mezcla de tokens lo calcularon.
Por qué importa
Porque el precio por token dejó de ser una curiosidad de laboratorio y se volvió parte del costo de cualquier producto. Si tu startup corre agentes todo el día, la diferencia entre 20 y 9 lucas por sesión es la diferencia entre contratar a alguien o no. Y porque el mercado de modelos baratos se llenó de anuncios idénticos: todos dicen ser el mejor en su rango y todos comparan contra el competidor que les conviene.
Para un equipo chico, elegir modelo es hoy una decisión de negocio, no de gustito técnico. Y esas se toman con números propios, no con la tabla del proveedor.
¿Cuánto baja realmente la cuenta?
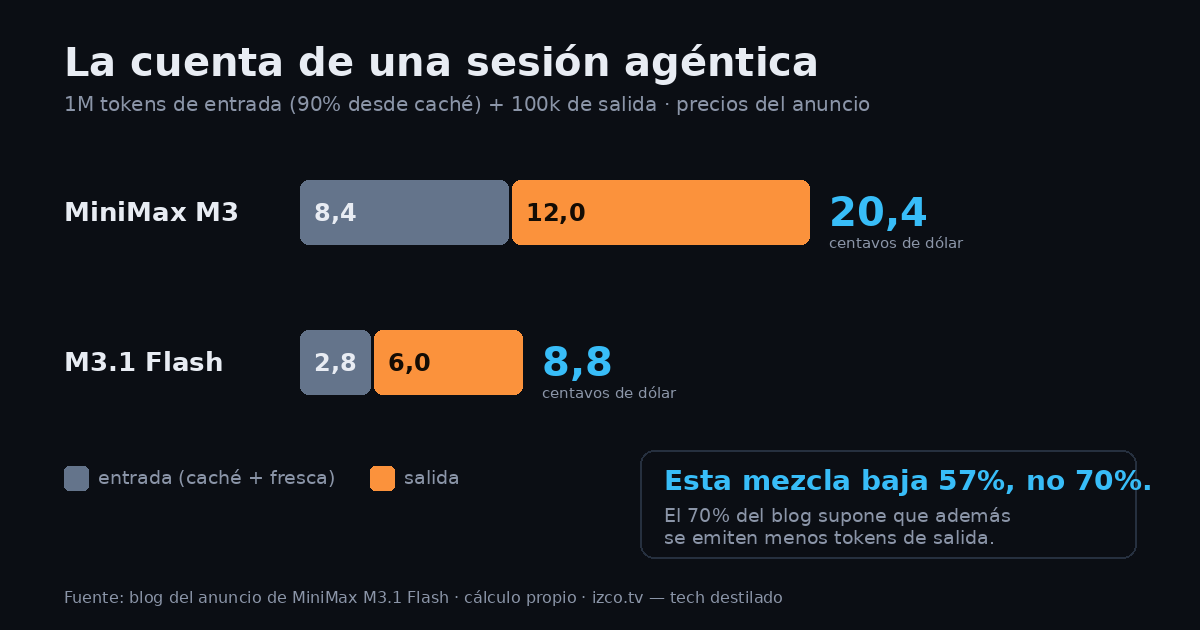
Hagamos la cuenta con los precios publicados y una sesión tipo: un millón de tokens de entrada, de los cuales el 90% viene de caché, más cien mil tokens de salida. Con el M3 anterior eso da 8,4 centavos de entrada y 12 de salida: 20,4 centavos. Con M3.1 Flash: 2,8 y 6,0, o sea 8,8 centavos. La baja es de 57%, no de 70%.
No es un detalle menor. Para llegar al 70% hay que suponer que el modelo además emite menos tokens de salida —lo que es plausible si razona menos—, pero entonces la comparación ya no es solo de precios, es de comportamiento. Y el comportamiento es justo lo que la comunidad está discutiendo.
Otro dato que importa más que la entrada: en cargas con mucho razonamiento, la salida manda. Un modelo puede ser baratísimo por token de entrada y carísimo por tarea si escribe de más. Varios comentarios apuntaron exactamente eso: mirar el precio de entrada y olvidar la salida es la forma más rápida de equivocarse con el presupuesto.
¿Por qué le achacan benchmaxing?
Porque M3.1 Flash ya circuló antes de su lanzamiento como modelo misterioso: se ofreció en OpenCode Go bajo el nombre Space Bunny, sin decir qué era. Y la recepción no fue buena. Varios usuarios que lo probaron a ciegas lo encontraron correcto pero mañoso —cometía errores al principio y los corregía después— y prefirieron volver a DeepSeek V4.1 Flash o a Qwen 3.8 Flash Next.
Cuando salió el anuncio con las tablas, la sospecha se ordenó: en la principal prueba de código, varios modelos aparecen clavados en 74%, un número demasiado redondo para ser casualidad. Y existe una revisión independiente de ese benchmark que encontró problemas en 23 de 113 tareas, más del 20%, y lo clasificó como defectuoso. O sea: la tabla que todos citan tiene averías conocidas.
No es que el modelo sea malo. Es que la evidencia pública no alcanza para creerle al gráfico, y MiniMax ya tiene historial de anuncios con selección conveniente de comparaciones.
¿Sirve para código de verdad?
Hay señales para ambos lados. Un usuario lo midió en un benchmark propio de lenguajes de programación y le fue parecido a DeepSeek V4 Pro, que no es poca cosa. Otro corrió una batería de analítica de datos y lo encontró empatado con Opus 5.5 y Argon en respuestas correctas, a un tercio del precio, con dos letras chicas: gasta muchos más tokens y es el modelo más lento que probaron en ese examen.
Y ahí está el patrón que se repite: barato por token, caro por tarea. Si el modelo piensa de más, la factura se come el ahorro y el reloj también.
¿Qué significa "Flash" en 2026?
Que ya no significa chico. Hace dos años un Flash era 27.000 millones de parámetros; hoy este anda en 428.000 millones totales con 23.000 activos. La etiqueta quedó para "económico y rápido", no para "liviano". Si alguien te dice que lo va a correr en su notebook, pregúntale cuánta RAM tiene antes de emocionarte.
Para quien juega en local, la conversación es otra: no importa tanto el tamaño nominal como cuánto ocupa cuantizado y a qué velocidad decodifica. Ahí los números del anuncio no sirven; sirve medir.
¿Y la velocidad de verdad?
La conclusión práctica es simple: en trabajo con agentes, lo que domina el tiempo es la generación token a token, y por eso un modelo con buena velocidad de lectura puede sentirse lentísimo igual. Los 13 tokens por segundo que se mencionan como referencia local están en el límite de lo usable: se puede, pero se siente como esperar buffering.
Y como siempre, la latencia del proveedor no es la del modelo: colas, límites y horarios cambian todo. El número del blog es el mejor caso.
Qué significa esto en Chile
- Precio: la factura llega en dólares y por millón de tokens, así que conviene traducirla a lucas antes de firmar. Un equipo que hace 300 sesiones agénticas al día nota la diferencia entre 20 y 9 lucas; una persona que lo usa para redactar correos, no. El ahorro real aparece cuando el volumen es alto y el modelo no se pone a divagar.
- Datos y clientes: si vas a procesar datos de clientes chilenos, la pregunta no es el precio sino dónde queda el log y quién lo ve. Hay proveedores con retención cero y otros que no; eso se conversa antes, no después. Para banca, salud o cualquier cosa con datos personales, el contrato pesa más que la tabla de precios.
- Oportunidad local: con costos marginales así de bajos se pueden armar productos que antes no cerraban: automatizaciones para pymes, procesamiento de documentos, atención de primer nivel. La pega no es el modelo, es la integración y el soporte; ahí hay negocio chileno de verdad.
Qué haría yo esta semana
- Elige diez tareas reales de tu pega y córrelas con el modelo actual y con M3.1 Flash. Mide tiempo, tokens de salida y si te sirvió el resultado.
- Calcula costo por tarea, no por token. Es la única cifra que se puede comparar entre modelos.
- Fija un presupuesto mensual por equipo y una alerta al 80%. Sin eso, el ahorro se lo come el entusiasmo.
- Revisa la letra chica de retención de datos del proveedor que vayas a usar. Si no la encuentras, ese es el dato.
- No cambies de modelo cada semana: el costo de re-aprender sus mañas es más alto que la diferencia de precio.
- Deja un modelo caro para planificar y uno barato para ejecutar. La mezcla suele rendir más que elegir un solo campeón.
Preguntas frecuentes
¿Es más barato que DeepSeek V4.1 Flash? Depende de la mezcla: en entrada y caché queda bien parado, en salida hay modelos con precios parecidos y mejor fama. La comparación honesta es costo por tarea terminada.
¿Puedo correrlo en mi casa? Con 428.000 millones de parámetros totales, necesitas harto hardware y una cuantización agresiva. Para la mayoría, la respuesta práctica es vía API.
¿Los pesos están disponibles? El anuncio los presenta como abiertos, pero todavía no estaban publicados al cierre de esta nota. Hasta que no salgan, la promesa es promesa.
¿Vale la pena cambiarse ahora? Solo si mediste. Si no mediste, cámbiate por precio y vas a terminar pagando más por tarea.