Kimi K3.1 Pro: frontera abierta a un quinto del precio, cuota aparte
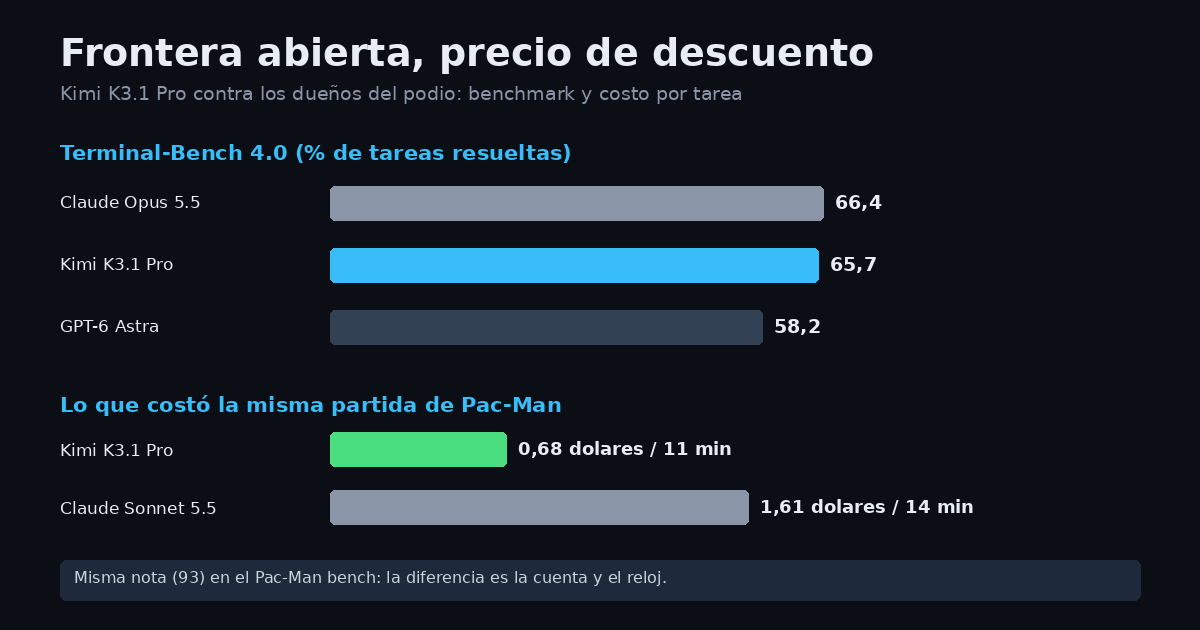
Resumen pa la micro: Moonshot lanzó Kimi K3.1 Pro, un modelo abierto de 3 billones de parámetros y 1 millón de tokens de contexto que saca 65,7% en Terminal-Bench 4.0, a 0,7 puntos de Claude Opus 5.5, y cobra 2 dólares por millón de tokens de entrada. Los pesos completos salen a más tardar el 4 de noviembre.
Qué soltó Moonshot, en simple
Kimi K3.1 Pro no es un modelo nuevo desde cero: es K3 con mucha más computación de post-entrenamiento, ese rato donde el modelo aprende a hacer tareas en vez de solo predecir texto. Moonshot dice que armó un entrenamiento por refuerzo conjunto sobre cientos de dominios y que eso le dio mejoras parejas en código, agentes, 3D y finanzas.
Los números que puso en la mesa, todos medidos por Moonshot: 65,7% en Terminal-Bench 4.0 (tareas de agente en terminal con tests reales), contra 66,4% de Opus 5.5 y 58,2% de GPT-6 Astra. En BenchCAD, que mide reconstrucción 3D desde vistas, marca 92,7% con herramientas, detrás del 96,2% de Opus y del 95,9% de Astra. Y en OfficeQA Pro v2, que es análisis de documentos financieros, llega a 64,4, que ellos declaran estado del arte.
Hay dos versiones: la normal y K3.1 Pro Highspeed, que según el blog corre 2 a 3 veces más rápido y se cobra al doble. Ambas con ventana de 1 millón de tokens, lo que en la práctica significa que le puedes tirar un repo entero encima sin partir el archivo en pedacitos.
Por qué importa
Porque la brecha entre "lo mejor que hay" y "lo que cualquiera puede descargar" se está achicando a un ritmo que ya no es teórico. Hace un año, un modelo abierto a 0,7 puntos del tope significaba "casi", y "casi" en agentes es un bucle infinito de errores. Hoy significa que el mismo agente que te falla con Opus en un 34% de las tareas te va a fallar en un 34,3% si lo cambias, pero pagando otra cosa.
Y porque el precio dejó de ser un detalle de finanzas y pasó a ser una decisión de arquitectura. A 2 dólares el millón de tokens de entrada y 10 el de salida, se puede correr un pipeline que antes era impensable, o se puede quemar el presupuesto del mes en una tarde si nadie mira la cuota.
¿Cuánto cuesta de verdad?
La API oficial queda en 2 dólares por millón de tokens de entrada y 10 por millón de salida, con el token cacheado a 0,20. Comparado con K3, que estaba en 3 y 15, es una baja de precio con un modelo más grande: 3 billones de parámetros contra 2,8. En la lista china la diferencia es más o menos la misma: la versión normal anda un 30% más barata que su antecesora.
El problema no es la API, es la suscripción. Ahí el asunto se pone fome: varios usuarios del plan de 99 dólares al mes reportaron que una sola sesión les comió la cuota de cinco horas en menos de una hora, sin siquiera pedir subagentes ni nada raro. Con el plan de 20, la experiencia es peor: alcanza para calentar el motor y poco más. Un usuario lo resumió sin anestesia: alcanzó a hacer el diseño y el plan, y después se pasó a otro modelo más barato a ejecutar.
O sea, el titular del precio es real, pero el camino barato no es la suscripción: es la API, o los pesos cuando salgan.
¿Es verdad que le sacaron la parte de ciberseguridad?
Sí, y es lo más interesante del anuncio. Moonshot escribe en el blog que para la liberación de pesos abiertos identificaron y removieron datos relacionados con ciberseguridad de las dos etapas de entrenamiento, y que dejaron las tareas generales de código "necesarias para que el modelo sea útil". Traducido: le cortaron el entrenamiento específico en exploit, no la capacidad de programar.
La frase que abrió el debate es otra: "K3.1 Pro es, por diseño, menos capaz en ciberseguridad ofensiva que lo que nuestro pipeline puede producir". Es decir, tienen adentro un modelo que sí sabe, y el que te entregan sabe menos.
Ahí hay tres lecturas que se pelearon en el hilo. Una: es honestidad y criterio de riesgo, porque un modelo abierto con capacidad ofensiva de frontera es un arma que no se puede desactivar después. Dos: es coartada, porque si el modelo igual queda arriba en los benchmarks, la frase no te está costando nada, y encima te blinda frente a los reguladores que andan mirando a los laboratorios chinos. Tres, la más incómoda: como los pesos completos salen el 4 de noviembre, cualquiera puede volver a meterle esa capacidad con fine-tuning; el freno es una sugerencia, no un candado.
Y hay un cuarto ángulo que casi nadie pone en la mesa: quien defiende software también necesita saber atacar. Un equipo de seguridad que no puede usar el modelo para buscar vulnerabilidades en su propio código queda tuerto, sobre todo si el atacante del frente sí tiene acceso a algo equivalente.
¿Los benchmarks se traducen en algo usable?
En el bakeoff de Pac-Man, donde cada modelo tiene que escribir un juego que se juega solo, K3.1 Pro empató con Sonnet 5.5 en 93 puntos, pero gastando 0,68 dólares y 11 minutos contra 1,61 y 14 del otro. En un benchmark propio de un lenguaje de programación adversarial, quedó a la par de Gemini 4 Argon y Fable 5.1, eso sí bastante más lento, y como el mejor modelo de pesos abiertos de esa prueba.
En el índice de Artificial Analysis aparece con 55, cuarto en la general, arriba de GPT-6 Astra y de Fable 5.1, y más rápido que ambos. La letra chica: para llegar a ese puntaje generó 150 millones de tokens, contra una mediana de 87 millones. Es un modelo verboso, y la verbosidad se paga en tokens de salida, que son los caros.
El otro detalle que aparece en las pruebas de la comunidad es el dibujo del pelícano en SVG, ese clásico informal para ver si el modelo entiende instrucciones raras. Ahí cumplió, con la pata y el pedal donde corresponde, que es más de lo que logran varios modelos caros.
Qué significa esto en Chile
- Precio: 2 y 10 dólares por millón de tokens pone un agente de código serio al alcance de una pyme de Providencia, no solo de una startup con ronda. Pero ojo con la cuota: si tu equipo va a usar la suscripción y no la API, calcula el consumo con lápiz antes de firmar el mes.
- Datos y clientes: mandar datos de clientes a una API en China no es lo mismo que mandarlos a una en EE.UU., y con la nueva ley de datos personales entrando en vigencia la conversación deja de ser técnica y pasa a ser legal. Si tu producto toca datos de personas, esto se conversa con abogado, no con el CTO solo.
- Oportunidad local: 3 billones de parámetros no caben en ningún server que vayas a comprar, así que el juego no es self-hosting puro: es integración, fine-tuning chico sobre la API y alguien que sepa medir costo por tarea terminada. Ese servicio, acá, escasea.
Qué haría yo esta semana
- Meter 10 dólares en la API y correr tus propios 20 prompts, no los del leaderboard. La única métrica que importa es cuántas veces tienes que repetirle la instrucción.
- Medir costo por tarea terminada, no por token. Con un modelo verboso, el precio por millón te miente.
- No mover nada de producción todavía. Prueba en paralelo, con el mismo set de tareas, y compara contra el modelo que ya usas.
- Anotar el 4 de noviembre en el calendario: ahí salen los pesos y se puede leer la licencia de verdad, que es donde suelen estar las sorpresas.
- Si estabas pensando en la suscripción mensual para el equipo, espera dos semanas y pregunta por consumo real a alguien que ya la tenga.
Preguntas frecuentes
¿Es realmente abierto?
Abierto con letra chica: el anuncio dice que los pesos completos salen a más tardar el 4 de noviembre, así que hasta esa fecha es un modelo de API. Y abierto no significa libre para cualquier uso: hay que leer la licencia cuando aparezca.
¿Lo puedo correr en mi máquina?
No. Son 3 billones de parámetros. Ni con cuatro GPUs de las caras. Lo que sí puedes hacer es correr una versión chica o usar la API; el discurso de "modelo abierto" acá es sobre auditoría y fine-tuning, no sobre tenerlo en el escritorio.
¿Qué diferencia hay con la versión Highspeed?
Velocidad: 2 a 3 veces más rápido, al doble de precio. Para chat se nota; para pipelines por lotes que corren de noche, no vale la pena pagarla.
¿Reemplaza a Opus 5.5?
En Terminal-Bench queda a 0,7 puntos, que en la práctica es empate técnico. En gusto, en manejo de interfaces y en esas cosas que no se benchmarkean, la comunidad sigue prefiriendo a Opus. La decisión real es de plata y de datos, no de puntaje.