DeepSeek V4.1-Flash no ganó los benchmarks y aun así le está comiendo la once a los gigantes
Pa' los apurados: DeepSeek sacó la V4.1-Flash-1017, un "minor update" que en la práctica rinde caleta para programar: parte al tiro, muestra cómo piensa y cuesta una fracción de Claude u Opus. Destilamos 680 comentarios de desarrolladores que lo usan a diario y estas son las 8 cosas que el titular no te contó, contadas a la chilena.
Qué pasó con DeepSeek V4.1-Flash
DeepSeek publicó la V4.1-Flash-1017: la venden como actualización menor, pero con mejoras fuertes en razonamiento, código, agentes y visión, más rápida y con respuestas más cortas. La prensa (Bloomberg) lo cubrió como un refresh más de la guerra de modelos. El anuncio oficial en X habla de mejor equilibrio entre rendimiento y costo. Hasta ahí el titular, que es la parte fome.
Por qué este modelo importa aunque no gane los benchmarks
Porque lo interesante no pasó en los puntajes, pasó en la pega real: programadores que lo usan todos los días dicen que se siente mejor trabajar con él que con modelos supuestamente superiores, y sale una fracción de lo que cuesta un Opus 5.5 o ChatGPT 6 Astra. Acá va el destilado de esa discusión.
¿Por qué DeepSeek se siente mejor si no es el más inteligente?
La idea más repetida es simple: no le gana a los grandes en puntajes, pero hace la pega al tiro (buen tiempo a primer token y velocidad según el proveedor), te muestra su cadena de pensamiento completa —cachai al tiro si se fue por las ramas— y no trata de ser más clever que tú: genera código como lo escribiría un programador de verdad, y te deja el control de las abstracciones.
¿En qué nivel de thinking conviene usarlo?
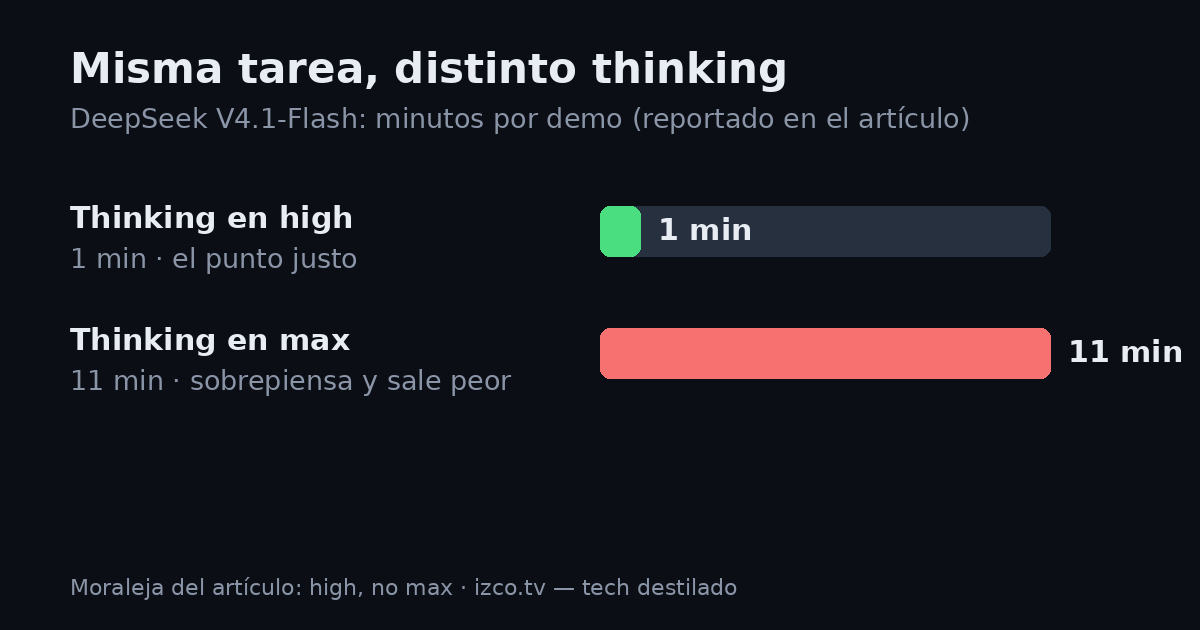
En high, no en max. Varios cuentan que en "max" el modelo sobrepiensa hasta ponerse peor y más caro: una demo que en high toma 1 minuto, en max toma 11. "High is good enough", y para programar a diario, 4.1 en high es el pan de cada día.
DeepSeek vs GLM: ¿cuál apaña más en la pega real?
Quienes corren ambos cuentan que GLM 5.3 Flash a veces se queda pegado en loops, toma 10 turnos donde DeepSeek toma 2 o 3, y repite muletillas que cuesta sacarle con instrucciones. Matiz honesto que también salió: GLM bloquea exploits igual que los demás, no es barra libre.
¿Por qué los modelos gringos joden tanto con revisiones morales?
Para trabajo de vulnerabilidades, los modelos gringos paran la pega a mitad de camino con revisiones de seguridad y bloqueos pegajosos, letales si trabajas en bases de datos o autenticación. Con los modelos chinos abiertos, ese mismo trabajo sale sin niñera. Ojo que esto corta para los dos lados: menos fricción también significa menos red de seguridad.
¿Es seguro pasarle mi código a DeepSeek?
No directo a su nube: la nube de DeepSeek entrena con tus prompts, así que si le pegas con código o datos de clientes, se los queda. La movida es inferencia con zero-retention (Fireworks y varios en OpenRouter, que además muestra insignias de privacidad por proveedor) o proveedores europeos.
¿Cuánto cuesta trabajar así en la práctica?
Acá hay que separar las cuentas, porque se mezclan dos bolsillos distintos. Por un lado, un programador cuenta cómo quema la suscripción de 200 dólares de Claude Code en menos de 24 horas con subagentes desbocados, y otro detectó que el 92% de sus tokens de caché se reescriben porque los tests demoran más que el TTL de 5 minutos. Esa es la cuenta usando modelos de Claude. Por otro lado, el mismo hilo trae la otra vereda: portear 2 juegos completos con DeepSeek V4.1 Flash costó unos 3 euros en tokens, como 3 lucas. El workflow que emerge es ese: modelo barato para picar piedra, frontier caro solo como revisor.
¿Sirven los benchmarks caseros que sube la gente?
A medias. Alguien puso 4 agentes a revisar el mismo repo sucio (más de 200 archivos, C++): DeepSeek encontró 1 problema grave relevante en 20 minutos, GLM tardó 65 minutos para un detalle de docs, GPT lo hizo en 5 y medio. Pero la misma discusión lo matiza: una corrida no es estadística por el no-determinismo, y lo más valioso es que ningún hallazgo se solapó entre modelos. Moraleja: usa varias familias, no te cases con una.
¿Qué hay detrás de la pelea por regular la IA?
Mientras desde Anthropic publican que los pesos abiertos son "peligrosos" y piden regular la frontera, en una conferencia de IA en París la sala se llenó para hablar de migrar fuera de Anthropic a pesos abiertos por ahorro. La regulación también es estrategia comercial, no solo seguridad.
Qué significa esto en Chile
- Precio: portear 2 juegos por 3 lucas en tokens vs una suscripción gringa de 200 dólares que se evapora en un día con subagentes desbocados. Haz la cuenta antes de contratar.
- Datos de clientes: si trabajas para bancos, retail o salud en Chile, NO le pegues directo a la nube de DeepSeek con código o datos reales. Usa un proveedor con zero-retention y revisa las insignias de OpenRouter primero.
- Oportunidad local: todavía no hay inferencia seria en Chile o LatAm de estos pesos abiertos con residencia de datos clara. Quien la monte (GPU + zero-retention + factura local) tiene un nicho botado.
Qué haría yo esta semana
- Pon a DS 4.1 Flash en high (no max) a hacer una code review chica de tu propio repo. Mide tiempo y tokens contra lo que usas hoy.
- Antes de pasarle código de clientes a cualquier API, revisa la insignia de privacidad del proveedor en OpenRouter.
- Si usas Claude Code con subagentes: saca los tests largos del loop del agente (el TTL de caché de 5 minutos te está quemando tokens) o córrelos tú.
Preguntas frecuentes
¿DeepSeek V4.1 Flash es mejor que GPT o Claude? En benchmarks, no. En el día a día programando, mucha gente lo prefiere por velocidad, transparencia y precio.
¿Qué nivel de thinking uso? High. Max sobrepiensa, demora más y sale más caro sin mejor resultado.
¿Puedo pasarle código de mi empresa? Solo si el proveedor tiene zero-retention (sin entrenamiento ni retención). La nube oficial de DeepSeek sí entrena con tus datos.
¿Cuánto cuesta comparado con Claude? Órdenes de magnitud menos por token; hay reportes de tareas completas por centavos de dólar contra suscripciones de 200 dólares que se evaporan en un día.