DeepSeek mete presión: busca y descarga páginas web a 0,75 dólares por mil
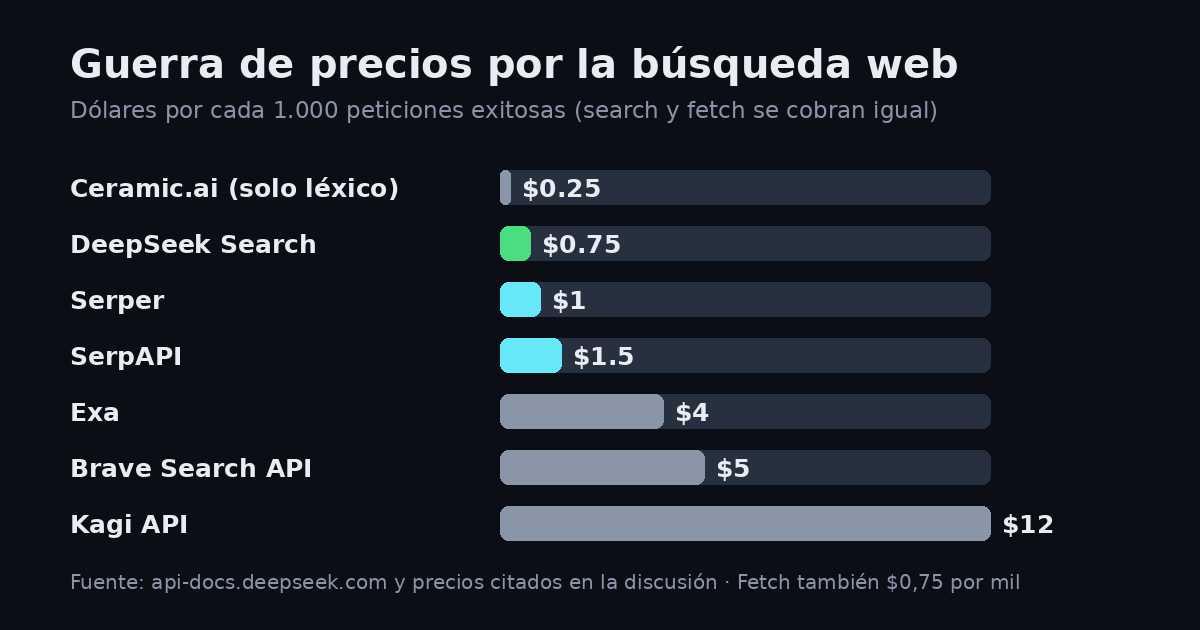
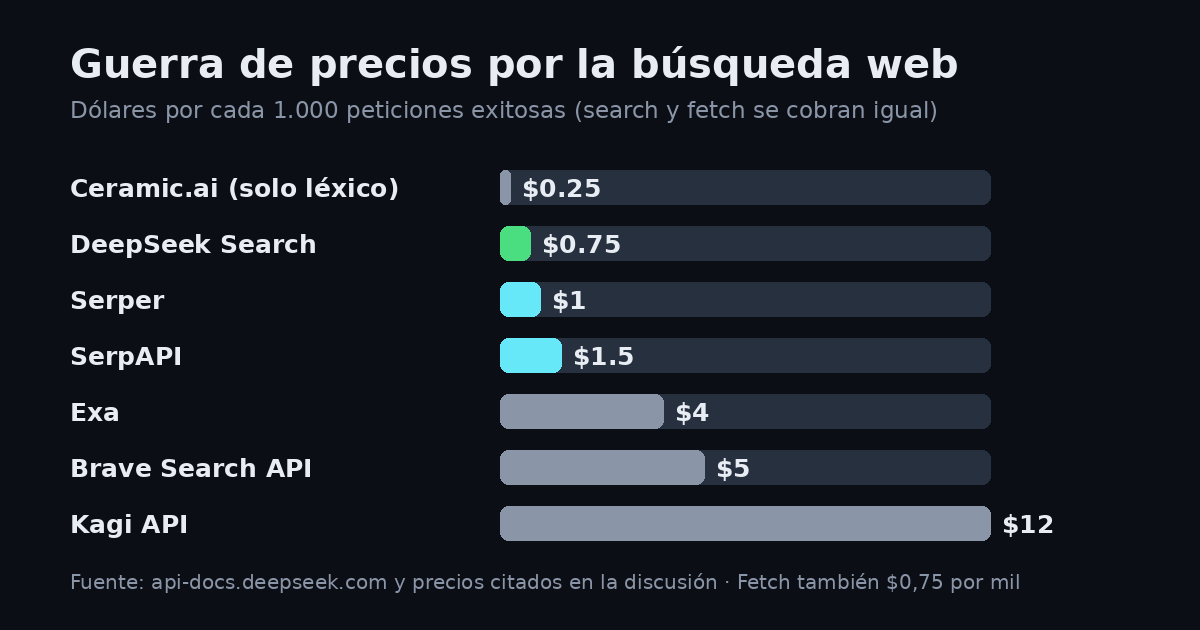
Cortita: DeepSeek lanzó Search y Fetch: dos APIs para que agentes de IA busquen en la web y bajen páginas completas, a 0,75 dólares por cada mil peticiones exitosas. Eso es hasta 16 veces más barato que Brave o Kagi, aunque barato no siempre significa mejor, y que las consultas políticamente sensibles vuelven vacías.
DeepSeek le pone precio de backend a la búsqueda web
La jugada es simple y contundente: dos endpoints JSON en la API de DeepSeek (/v1/tools/search y /v1/tools/fetch), con el mismo bearer token de siempre. Search consulta un índice propio (nada de revender Google) y devuelve resultados con título, URL, snippet y, si lo pides, el contenido de la página. Fetch descarga cualquier URL. La gracia del modelo de negocio: cobran solo por petición exitosa —HTTP 200 con resultado—; búsquedas vacías, errores y timeouts no se cobran. Operadores tipo site:, lang:, after: y frases exactas incluidos, como en un buscador de verdad.
El precio rompe la mesa de la conversación: 0,75 dólares por mil peticiones en ambos servicios, contra los 5 de Brave, los 12 de Kagi o los 4 de Exa. La única más barata de la comparación es Ceramic.ai, que cuesta 0,25 pero hace matching puramente léxico con un índice desactualizado, según los que la probaron. Bonus de lanzamiento: las búsquedas web integradas de Claude Code y Codex pasan por esta API y no se cobran durante las primeras dos semanas. El límite de ritmo es de 5 peticiones por segundo por cuenta (más un límite por dominio en fetch), pensado para agentes, no para servir una app con usuarios concurrentes.
Por qué importa
Porque la búsqueda web se convirtió en el insumo crítico de los agentes: un trabajo de investigación dispara decenas de búsquedas y cientos de descargas, y ese costo estaba multiplicándose en la factura de todos. Con este movimiento, DeepSeek presiona directamente los márgenes de Exa, Parallel, Firecrawl, Tavily y compañía, startups que levantaron plata con valores bastante más altos para resolver exactamente este problema. El hilo lo dijo sin anestesia: la demanda existe, pero los márgenes que aguantan esas valoraciones, con precios así, ya no.
Y hay una segunda lectura geopolítica: DeepSeek está financiada por el hedge fund High-Flyer, no necesita que este producto sea rentable, y está vendiendo infraestructura de acceso a la web a precio de regalo. Cuando el acceso a la información es el negocio, quien fija el precio de la puerta controla qué entra.
¿Cacha algo este servicio?
Los reportes de primera mano son honestos. Lo que hace bien: fetch que ejecuta JavaScript (nadie cae por una página que requiere render), resultados estructurados, y un precio que permite a un agente investigar sin mirar el cuentagotas. Lo que tiene peros: quienes corrieron sus propios benchmarks lo califican como "barato pero no muy bueno", recomendando Jina gratis para casos simples y Parallel, Firecrawl, Tavily o Exa pagados si la calidad importa. En pruebas lado a lado, Exa y Tavily siguen ganando en relevancia. El fetch, además, devuelve el texto de la página pero pierde los enlaces, lo que limita navegaciones profundas.
Y el hallazgo más incómodo de la conversación: un usuario probó consultas políticamente sensibles y recibió cero resultados. Nadie mide eso cuando compara precios, pero si tu agente investiga temas que tocan a China, el índice tiene un agujero silencioso. Suma el detalle técnico: el tráfico de fetch sale de infraestructura china (Huawei Cloud en Hong Kong), con un user agent de Firefox en Linux configurado en China. O sea, todas tus descargas nacen desde una IP de ese lado del mundo, con lo que eso implica para sites que te bloquean por geografía.
¿Por qué Google no vende una API de búsqueda pagada?
Es una pregunta válida: si hay mercado pagando hasta 12 dólares por mil búsquedas, ¿por qué el buscador líder no vende eso? porque el modelo de Google no es vender búsquedas, es cosechar datos de personas para publicidad dirigida. Una API pagada destruiría el sistema de vigilancia. Irónicamente, ese vacío es lo que sostiene todo este mercado paralelo de providers, scrapers y proxies residenciales. Google tiene algo (Vertex Search) pero lento y para cargas asíncronas, nada que un agente en tiempo real quiera usar. Cloudflare ya reaccionó con su propia API de búsqueda web, otra señal de que este terreno se está disputando rápido.
¿Y la web que se rompe en el camino?
La parte más ácida: dueños de sitios pequeños contando que reciben millones de peticiones claramente automatizadas desde miles de IPs residenciales, con user agents falsificados y sin respetar robots.txt. Cada API de fetch barata es un multiplicador de ese tráfico, y el resultado visible es internet lleno de captchas, Anubis y Cloudflare para todos, humanos incluidos. La discusión ética quedó abierta: los agentes grandes (Claude, ChatGPT) se identifican y respetan bloqueos en su herramienta oficial, pero cuando les niegan el acceso, algunos ejecutan curl con otro user agent por su cuenta, sin consultar al usuario. "Succeed at all costs" es una mala política de seguridad, dice un bando; "si está en internet público, es público", dice el otro. DeepSeek al menos documenta backoff adaptativo ante 429 y 503, aunque el escepticismo del hilo es razonable: cuando te llega el error, el daño ya llegó.
Qué significa esto en Chile
- Precio: un agente que antes gastaba 12 dólares por mil búsquedas en Kagi ahora puede hacerlo por menos de un dólar. Para un proyecto indie o una pyme que automatiza investigación, la factura de búsqueda deja de ser línea de presupuesto y pasa a ser ruido.
- Datos/clientes: si vendes productos con IA que investigan (informes, monitoreo, chatbots con fuentes), revisa la procedencia del proveedor de búsqueda antes de comprometerte con clientes enterprise: el índice censurado y el egreso desde Hong Kong son preguntas que un auditor serio va a hacer.
- Oportunidad local: el agujero que dejó Google es una mini-industria. En LatAm nadie está armando índices ni APIs de búsqueda regional bien hechas (contenido chileno en .cl, prensa local, diarios regionales): nicho chico, pero real, y la guerra de precios deja el arriendo del backend casi regalado.
Qué haría yo esta semana
- Si tienes un agente que busca en la web, corre tu propio bench de 20 consultas típicas contra DeepSeek Search y tu proveedor actual, y compara relevancia resultado por resultado. El precio es tan bajo que la prueba completa cuesta unas chauchas.
- Mide tu patrón de peticiones: si superas las 5 por segundo, esta API no es para producción concurrente. Para agentes personales y batch jobs, va sobrado.
- Revisa qué significa "petición exitosa" en tu flujo: si tu agente hace búsquedas que suelen volver vacías, no pagas, pero tampoco resuelve. El operador
site:ylang:ayuda a afinar. - Si administras un sitio y te está llegando tráfico de fetch masivo, considera Anubis o pruebas de trabajo ligero: lo barato de estas APIs va a multiplicar los rastreadores, y la defensa es tuya.
Preguntas frecuentes
¿Por qué pagar si puedo scrapear gratis con SearXNG?
Porque el scraping casero se te cae a la primera cortina de Cloudflare: rate limits, captchas y bloqueos de IP llegan rápido aunque uses IP residencial. Los que migraron a APIs pagadas en el hilo lo hicieron por confiabilidad y latencia, no por flojera. Para volúmenes chicos y ocasionales, los free tiers de Tavily o Exa igual te sirven.
¿El fetch respeta los bloqueos de los sitios?
Ejecuta JavaScript y va disfrazado (Firefox en Linux, idioma China), o sea, pasa como navegador normal. Documentan backoff ante 429/503 y límite por dominio, pero no hay programa de bots verificados como el de Cloudflare. Si un sitio quiere bloquear este tipo de tráfico, la pelea es técnica y la gana quien tenga más paciencia.
¿Sirve para buscar noticias recientes?
Tiene operadores de fecha (after:, before:) y soporta restringir por sitio y lenguaje, incluido lang:es. El índice es propio, así que la frescura exacta no está documentada; los benchmarks del hilo sugieren que para búsqueda general va bien, pero para nichos específicos conviene comparar contra tu provider actual antes de migrar.
¿De qué me sirve si uso Claude o ChatGPT y no DeepSeek?
Las APIs son servicios independientes: cualquier agente, harness o script que hable JSON puede usarlas con una API key de DeepSeek, aunque tu modelo principal sea otro. De hecho, Claude Code y Codex ya rutean su búsqueda web por esta API (gratis las primeras dos semanas del lanzamiento, después con precio normal).
Fuentes
- DeepSeek API Docs: Search & Fetch (precios, endpoints, operadores y límites oficiales)
- Cloudflare: introducing Web Search API (la respuesta del otro gigante al mismo problema)
- searxng-ai-kit (alternativa self-hosted gratuita mencionada en la discusión)