DeepInfer: DeepSeek abrió su motor de inferencia y dejó la boleta a la vista
En buen chileno: DeepSeek liberó con licencia Apache 2.0 el motor de inferencia que usa para servir DeepSeek V4.1 Flash y, de pasada, dejó a la vista los números que la propia DeepSeek reporta de su operación: 155 billones de tokens al día por clúster y 38 dólares de ingreso por tarjeta cada hora a precio off-peak. El repo no incluye el sistema de KV cache, que es justo la pieza que explica el margen.
Qué soltó DeepSeek, exactamente
El repositorio es deepseek-ai/DeepInfer y salió con Apache 2.0, el mismo tipo de licencia que usa medio mundo para librerías. En las primeras horas pasó las 10.800 estrellas y los 950 forks, con una curiosidad: solo tres commits. No es un proyecto comunitario que lleva años creciendo; es el stack con el que DeepSeek sirve su modelo estrella, publicado de una vez.
El README es honesto en dos cosas que casi nadie leyó. Primero, soporta un solo modelo: DeepSeek-V4.1-Flash-1017. Segundo, dice literalmente "offline inference", y lista lo que no viene en el release: el sistema de KV cache, la separación de prefill y decode (VE/Prefill/Decode disaggregation) y el balanceo entre réplicas. O sea, trae el motor; no trae la capa que lo convierte en un servicio para miles de usuarios al mismo tiempo.
De dónde salió: el paper del repo dice que se construyó sobre vLLM, con ideas de SGLang y TensorRT-LLM. No es magia nueva desde cero, es lo que DeepSeek le fue agregando encima a lo que ya existía.
Por qué importa
Porque el costo por token es la variable que define qué empresa sobrevive en AI, y hasta ahora los que cobran sabían el número y los que pagamos no. Un release así no solo entrega código: entrega la aritmética del negocio.
Y porque la cifra de ingreso por tarjeta no es un detalle financiero: es la respuesta a la pregunta que se repite cada tres meses en Twitter, en el matinal y en el directorio. Si DeepSeek reporta 38 dólares de ingreso por tarjeta y hora —sin decir con qué tarjeta hizo la cuenta—, la discusión sobre si la inferencia es un negocio de verdad deja de ser una opinión.
¿Cuánto ingresa por tarjeta y cuánto le cuesta?
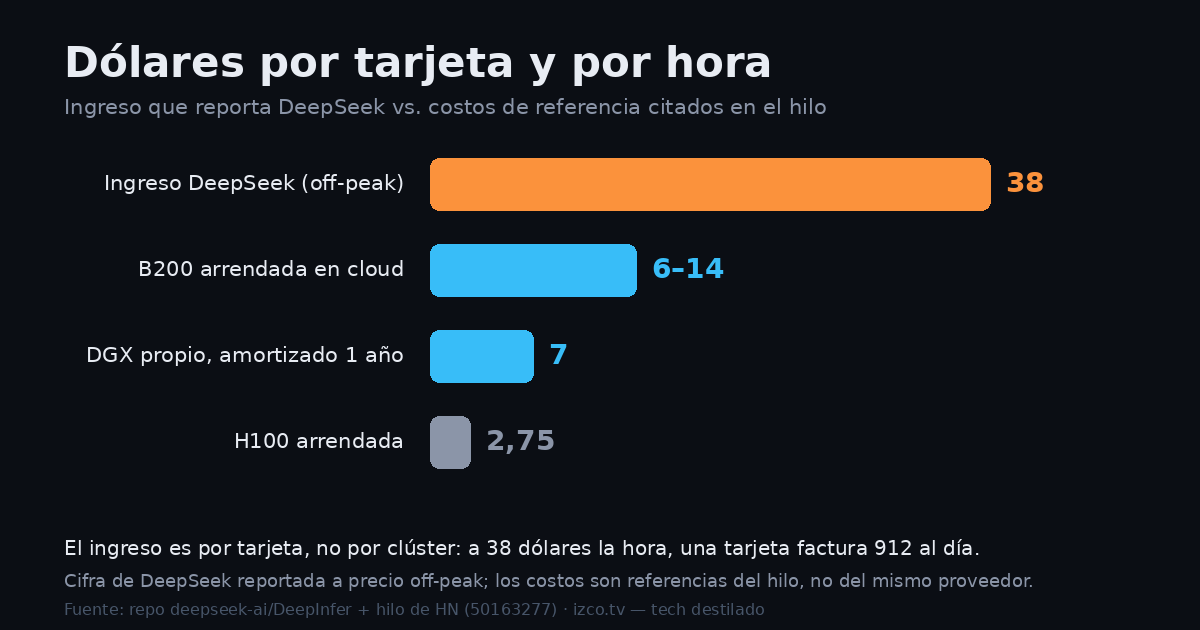
El dato viene de un post de DeepSeek en Zhihu: "el throughput de un solo clúster es 155 billones de tokens al día y el ingreso total es de 38 dólares por tarjeta por hora, a precio off-peak". Antes de sacar cuentas, tres cosas. Primero: es ingreso, no utilidad; el post no descuenta el costo de esa tarjeta en esa misma hora. Segundo: no dice con qué tarjeta se hizo la cuenta, y el repo solo nombra SM100 de NVIDIA y Ascend 950 de Huawei. Tercero: off-peak es fuera de la hora peak, y en la propia API de DeepSeek eso vale cerca de la mitad de la tarifa normal, así que a tarifa normal la cifra sería bastante más alta. O sea, tómalo como lo que es: una cifra reportada por DeepSeek, no un dato auditado.
Para comparar con algo, aparecieron tres referencias de costo que sirven de piso:
- Servidor propio amortizado: un DGX de alta gama se paga en un año a poco más de 7 dólares por tarjeta y por hora.
- Arriendo en cloud: una B200 se consigue entre 6 y 14 dólares la hora, ya con hosting y margen del proveedor incluido.
- H100 arrendada: alrededor de 2,75 dólares la hora según precios de prensa.
Con esos números, 38 dólares de ingreso por tarjeta y hora es una cifra de casino, no de librería. Aunque el costo se lleve la mitad, lo que queda explica por qué DeepSeek puede regalar pesos abiertos sin que se le caiga el negocio. La diferencia entre ingreso y utilidad no es un tecnicismo: es la diferencia entre un buen negocio y el negocio más rentable de la historia.
¿Entonces OpenAI y Anthropic están muertas?
No, una cosa es que la inferencia sea rentable y otra que el negocio completo lo sea. Los laboratorios grandes cargan entrenamiento, investigación y sueldos de gente carísima; la inferencia paga la luz, no la fiesta entera.
Lo que sí cambia es el argumento de venta. Si el motor es un commodity con licencia Apache, la ventaja deja de estar en "cómo sirvo el modelo" y se muda a dónde siempre estuvo en los negocios aburridos: contratos, distribución, datos propios, soporte y marca. Eso es menos sexy que un benchmark y mucho más difícil de copiar.
Si la inferencia se vuelve commodity, justificar una valorización de un billón de dólares pasa a ser un ejercicio de fe. No porque el negocio no exista, sino porque el múltiplo que se paga hoy asume un margen que este release hace bastante más difícil de defender.
¿Por qué el KV cache es la parte que importa?
Porque es lo que hace que conversar con un modelo no te cueste como si empezara de cero cada vez. El KV cache guarda el estado de la conversación para no recalcularlo; en DeepSeek son unos 890 bytes por token, y con 32K de contexto eso son menos de 30 MB. El truco de verdad es lo que hacen con eso: mover el cache desde la VRAM a la RAM del servidor y de ahí a disco, y mandar cada request a la máquina donde ese cache ya vive. La comunidad reporta tiempos de vida de cache de 8 horas o más, algo que ningún otro proveedor iguala.
Eso es exactamente lo que no viene en el release. Trajeron el motor, se guardaron la cañería. Y tiene sentido: si regalan la cañería, regalan el negocio.
¿Y las tarjetas chinas en todo esto?
El README dice soporte para GPUs NVIDIA SM100 y para NPUs Huawei Ascend 950. Lo segundo es la parte políticamente interesante: es código que corre en hardware que en Estados Unidos no puedes comprar ni importar. Para el resto del mundo es una alternativa concreta; para un cliente en Chile significa que, en teoría, hay un camino que no depende de la lista de espera de NVIDIA.
En teoría. Porque el ecosistema de Ascend no es CUDA, los proveedores cloud locales no lo ofrecen, y conseguirlo implica importación, aduana y soporte que nadie te va a dar en español.
Qué significa esto en Chile
- Precio: el número que te importa no es el de DeepSeek, es el de tu proveedor. La presión a la baja por token llega igual y llega rápido; si tu contrato es anual y a precio fijo, tienes con qué renegociar en la próxima renovación.
- Datos y clientes: correr pesos abiertos en tu propia infraestructura es la única forma de que los datos del cliente no salgan del país, y eso vale plata en banca, salud y sector público. Ojo con dos cosas: la licencia del modelo es aparte de la del código, y si el proveedor entrena con tus datos eso es tratamiento de datos personales bajo la Ley 21.719, que entra en vigencia el 1 de diciembre de 2026.
- Oportunidad local: hay pega real y poco glamorosa en bajar el costo por token de empresas que ya están pagando de más: cache, routing, batch, elegir el modelo chico para la tarea chica. Nadie está vendiendo eso en Santiago y todos lo necesitan.
Qué haría yo esta semana
- Calcula tu gasto real por token y tu tasa de acierto de cache. En cargas conversacionales, ahí está la mayor parte del ahorro antes de cambiar de modelo.
- Toma 20 prompts reales de tu pega y córrelos contra V4.1 Flash y contra el modelo que pagas hoy. Compara en tu tarea, no en el leaderboard.
- Si te tienta auto-hospedar, haz la cuenta del payback antes de comprar una GPU. Si no se paga en menos de un año, no lo hagas: el hardware se deprecia más rápido que tu idea.
- Revisa si tu contrato actual permite que el proveedor entrene con tus datos. Esa cláusula vale más que el descuento.
- Si le vendes a empresas de Estados Unidos, mira la orden de DHS sobre DeepSeek antes de meterlo en cualquier cadena de suministro. El que se quema por no leer es el proveedor chico, no el grande.
Preguntas frecuentes
¿Puedo correrlo en mi casa? No. Pide Linux, GCC 13 o superior, Python 3.12, CUDA 13 y GPUs SM100 o Ascend 950. Es un stack de datacenter, no una app de escritorio, y el modelo completo no cabe en un PC gamer por más que insistan en los foros.
¿Es open source de verdad? El código del motor sí, Apache 2.0. Los pesos del modelo tienen su propia licencia, que es donde suelen vivir las letras chicas. Revisa las dos antes de meterlo en un producto.
¿Esto baja el precio de los tokens mañana? Presión sí, garantía no. Los proveedores que corren modelos abiertos compiten entre ellos y eso se traspasa; los que venden modelos cerrados bajan precio cuando pierden cuentas, no cuando alguien publica un repo.
¿De dónde sale el dato de los 38 dólares? De un post de DeepSeek en Zhihu, en chino. La cifra es ingreso por tarjeta y hora a precio off-peak; el post no dice qué tarjeta ni qué costos. Acá la tratamos como reportada por la empresa, no como verificada.
¿Es más rápido que vLLM? El repo trae benchmarks propios medidos en 4 SM100 para prefill y 64 para decode, y ahí se ve bien. Pero benchmark de casa no es benchmark independiente: falta que alguien de afuera lo reproduzca.